5. 读写管线
5.1 写入管线:Remember
mnemon remember 是写入记忆的核心命令。它包含内置的 diff 步骤,在存储前自动检测重复和冲突。写入事务在一个 SQLite 事务中原子执行。
流程详解
mnemon remember "选择 Qdrant 作为向量数据库" \
  --cat decision --imp 5 --entities "Qdrant,Milvus"
第一步:校验输入
- 类别必须是六种之一
- 重要度 1-5
- 内容不超过 8000 字符
- 标签最多 20 个,实体最多 50 个
第二步:生成嵌入(事务外)
- 如果 Ollama 可用:HTTP POST → nomic-embed-text → 768 维 float64 向量
- 如果不可用:embedding = nil,后续降级为 token 重叠
第 2.5 步:内置 Diff(事务外,只读)
生成相似度建议,并与所有活跃 insight 进行精确内容比较:
- 内容逐字节完全相同 → 跳过插入,返回
action="skipped"和diff_suggestion="DUPLICATE" - 内容不同 → 正常插入,返回
action="added",保留启发式diff_suggestion供复核
相似度在有嵌入时使用余弦计算,否则使用 token 重叠。
相似度与自动抽取的实体都无法确定一个事实是否取代另一个。
精确内容查找不受相似度候选数量限制。
--no-diff 会禁用两项检查,连完全重复的内容也会插入。
第三步:原子事务
BEGIN TRANSACTION
  ① INSERT insight(UUID, content, category, importance, tags, entities, source)
  ② UPDATE embedding(如果有向量)
  ③ Graph Engine: OnInsightCreated
     ├── CreateTemporalEdge    → backbone + 24h proximity
     ├── CreateEntityEdges     → regex + 词典提取 → 共现链接
     ├── CreateCausalEdges     → 关键词 + token 重叠 → 自动因果边
     └── CreateSemanticEdges   → cos ≥ 0.80 自动链接
  ④ RefreshEffectiveImportance → 更新 EI 衰减值
  ⑤ AutoPrune                 → 软删除超过保护期且 EI 最低的条目
                                 + 每个 ID 必须写入 oplog
COMMIT
第四步:候选输出(事务后,只读)
FindSemanticCandidates:cos ∈ [0.40, 0.80) 的语义候选FindCausalCandidates:2-hop BFS 邻域中的因果候选
第五步:JSON 输出
{
  "id": "abc-123",
  "action": "added",
  "diff_suggestion": "ADD",
  "edges_created": {"temporal": 2, "entity": 3, "causal": 1, "semantic": 1},
  "semantic_candidates": [
    {"id": "def-456", "content": "...", "cosine": 0.72, "auto_linked": false}
  ],
  "causal_candidates": [
    {"id": "ghi-789", "content": "...", "hop": 1, "suggested_sub_type": "causes"}
  ],
  "embedded": true,
  "effective_importance": 0.85,
  "auto_pruned": 0,
  "auto_pruned_ids": []
}
action 为 "added"(新增)或 "skipped"(与活跃记忆内容逐字节完全相同,
未插入)。跳过时,兼容字段 replaced_id 指向保持不变的已有记忆。
启发式 UPDATE、CONFLICT 或近似 DUPLICATE 建议仍会返回 action="added"。
LLM 收到这个输出后,可以评估候选并通过 mnemon link 命令建立它认为合理的边。
5.2 读取管线:Smart Recall
mnemon recall 是 Mnemon 的核心检索算法。Smart recall 是所有查询的默认模式。它结合意图检测、多信号锚点选择、Beam Search 图遍历和多因子重排序,实现了意图感知的图增强检索。使用 --basic 可回退到旧版 SQL LIKE 检索。
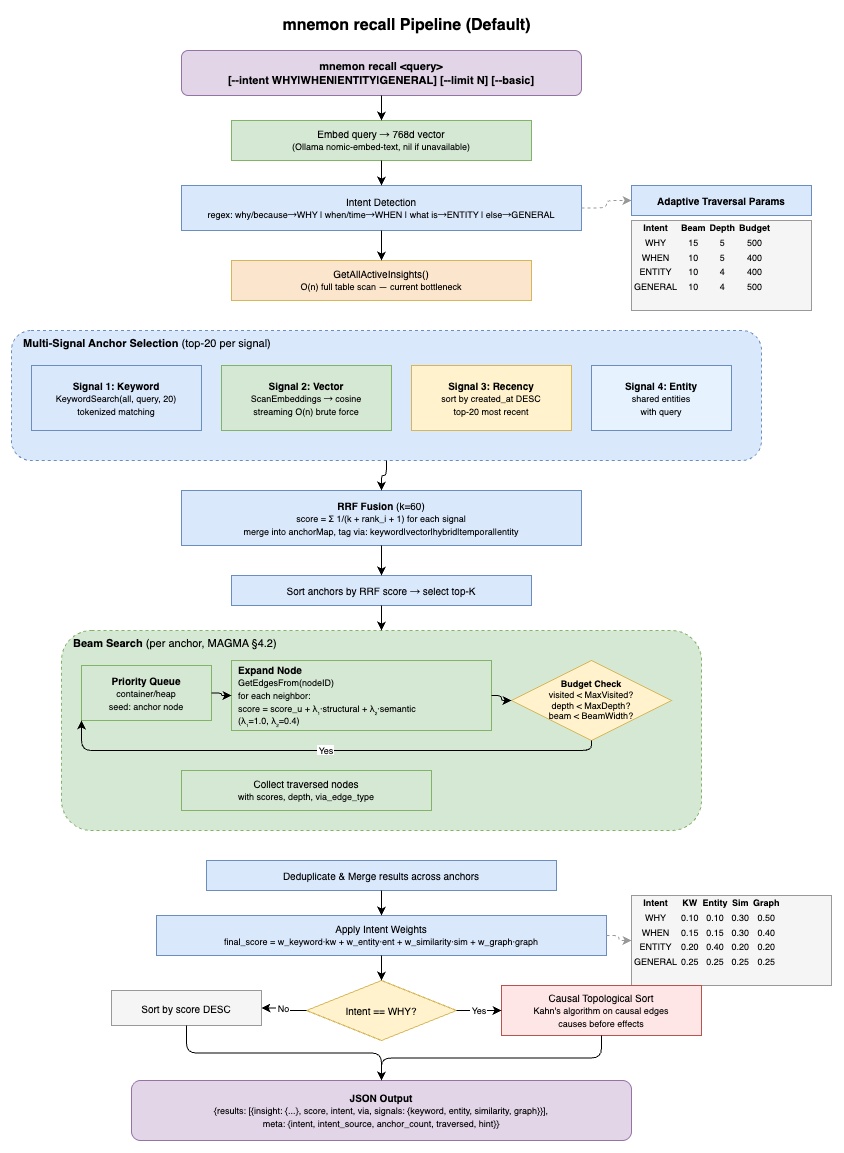
Step 1:意图检测
通过正则匹配自动识别查询意图:
| 意图 | 触发模式 |
|---|---|
| WHY | why, reason, because, cause, motivation, 为什么, 原因, 理由 |
| WHEN | when, time, before, after, timeline, 什么时候, 何时, 时间 |
| ENTITY | what is, who is, tell me about, 是什么, 谁是, 关于 |
| GENERAL | 以上都不匹配 |
另有印地语、西班牙语、现代标准阿拉伯语、法语、孟加拉语、葡萄牙语、 印度尼西亚语、俄语和德语的部分疑问句模式,详见 Recall 意图检测。词边界使用 Unicode 规则; 新增语言的线索互相冲突或与英/中文冲突时回退到 GENERAL。仅含英/中文线索 时保留原有计数及 ENTITY 平分规则。这是有限的词语启发式,不是语义理解。
--intent WHY|WHEN|ENTITY|GENERAL 可对任意语言查询覆盖自动检测。宿主可从
用户含义选择意图,无需翻译查询或调用另一个服务。--verbose 显示
meta.intent 和 meta.intent_source(auto 或 override)。
Step 2:多信号锚点选择(RRF 融合)
并行运行多个信号,通过 Reciprocal Rank Fusion 合并:
Signal 1: Keyword     → KeywordSearch(all_insights, query, top-20)
Signal 2: Vector      → CosineSimilarity(query_vec, all_embeddings, top-20)
Signal 3: Recency     → sort by created_at DESC, top-20
Signal 4: Entity      → 与 query 共享实体的 insights

RRF Score = Σ  1 / (k + rank_i + 1)    (k = 60)
                 for each signal
每个 insight 在不同信号中可能有不同排名,RRF 融合产生稳健的综合排名。
Step 3:Beam Search 图遍历
从每个锚点出发,在四图上进行 Beam Search:
for each anchor:
    priority_queue = [(anchor, initial_score)]
    visited = {}

    while budget_remaining:
        node = pop(priority_queue)
        for edge in GetEdgesFrom(node):
            neighbor = edge.target
            structural_score = edge.weight × intent_weight[edge.type]
            semantic_score = cosine(vec_neighbor, vec_query)
            total = score_node + λ₁·structural + λ₂·semantic
            //  λ₁ = 1.0(结构权重),λ₂ = 0.4(语义权重)

            if total > best_score[neighbor]:
                update(neighbor, total)
push(priority_queue, neighbor)自适应参数:
| 意图 | Beam Width | Max Depth | Max Visited |
|---|---|---|---|
| WHY | 15 | 5 | 500 |
| WHEN | 10 | 5 | 400 |
| ENTITY | 10 | 4 | 400 |
| GENERAL | 10 | 4 | 500 |
WHY 查询使用更宽的 beam 和更深的遍历,因为因果链通常跨越多跳。
Step 4:多因子重排序
对所有收集到的候选,计算四维分数并加权求和:
keyword_score  = token_intersection / query_token_count
entity_score   = matched_entities / max(1, query_entities_count)
similarity     = cosine(vec_candidate, vec_query)
graph_score    = (traversal_score - min) / (max - min)   // min-max 归一化

final = w_kw·keyword + w_ent·entity + w_sim·similarity + w_gr·graph
权重因意图而异:
| 意图 | Keyword | Entity | Similarity | Graph |
|---|---|---|---|---|
| WHY | 0.10 | 0.10 | 0.30 | 0.50 |
| WHEN | 0.15 | 0.15 | 0.30 | 0.40 |
| ENTITY | 0.20 | 0.40 | 0.20 | 0.20 |
| GENERAL | 0.25 | 0.25 | 0.25 | 0.25 |
Step 5:WHY 后处理 — 因果拓扑排序
如果意图是 WHY,额外进行 Kahn 算法拓扑排序:沿因果边排列结果,使原因在前、结果在后。
Signals 透明度
每个检索结果都附带详细的信号分解:
{
  "insight": {"id": "...", "content": "..."},
  "score": 0.73,
  "intent": "ENTITY",
  "via": "keyword",
  "signals": {
    "keyword": 0.85,
    "entity": 0.60,
    "similarity": 0.72,
    "graph": 0.45
  }
}
这是 Mnemon 的独特创新:将检索管线的内部信号暴露给宿主 LLM。由于宿主 LLM 拥有完整的对话上下文,它能比管线内部的任何算法做出更好的重排序判断。
5.3 去重与冲突检测:Diff
flowchart TD
    Write[remember / import] --> Bypass{"--no-diff?"}
    Bypass -->|是| Add[插入新记忆,保留已有事实]
    Bypass -->|否| Exact{与活跃记忆逐字节完全相同?}
    Exact -->|是| Skip[跳过插入,返回已有记忆的标识]
    Exact -->|否| Add
    Write -. 仅 remember .-> Advisory[相似度建议供复核参考]
Diff 已内置于 remember — 无需单独调用。当调用 mnemon remember 时,它会自动在插入前运行 diff 检查。
调用 remember 时,内置 diff 在事务之前运行:
- 对所有活跃 insight 计算相似度(有嵌入时使用余弦相似度,否则使用 token 重叠)
- 独立扫描所有活跃 insight,检查逐字节相同的内容。相似度仅提示潜在关系, 只有精确相等才允许跳过写入:
| 内容 | Diff 建议 | 行为 |
|---|---|---|
| 与活跃记忆逐字节完全相同 | DUPLICATE | 跳过插入,返回 action="skipped" |
| 内容不同,任意相似度 | ADD、UPDATE、CONFLICT 或 DUPLICATE | 返回 action="added",保留已有记忆 |
import 使用相同的精确内容查找规则,保留不同内容。
两条命令均可通过 --no-diff 无条件插入。
基于容量的自动清理仍是独立的生命周期策略。
典型工作流
先保存新内容,仅在确有需要时淘汰指定的旧事实:
# Diff 自动执行,结果仅供参考
mnemon remember "选择 PostgreSQL 替代 SQLite 作为主数据库" \
  --cat decision --imp 5 --source agent
# → 完全重复:action="skipped",已有记忆保持不变
# → 内容不同:action="added",保留已有记忆

# 如果新事实取代了指定旧记忆,先验证,再淘汰
mnemon show <new-id>
mnemon forget <old-id>